FOIRE AUX questions
No items found.

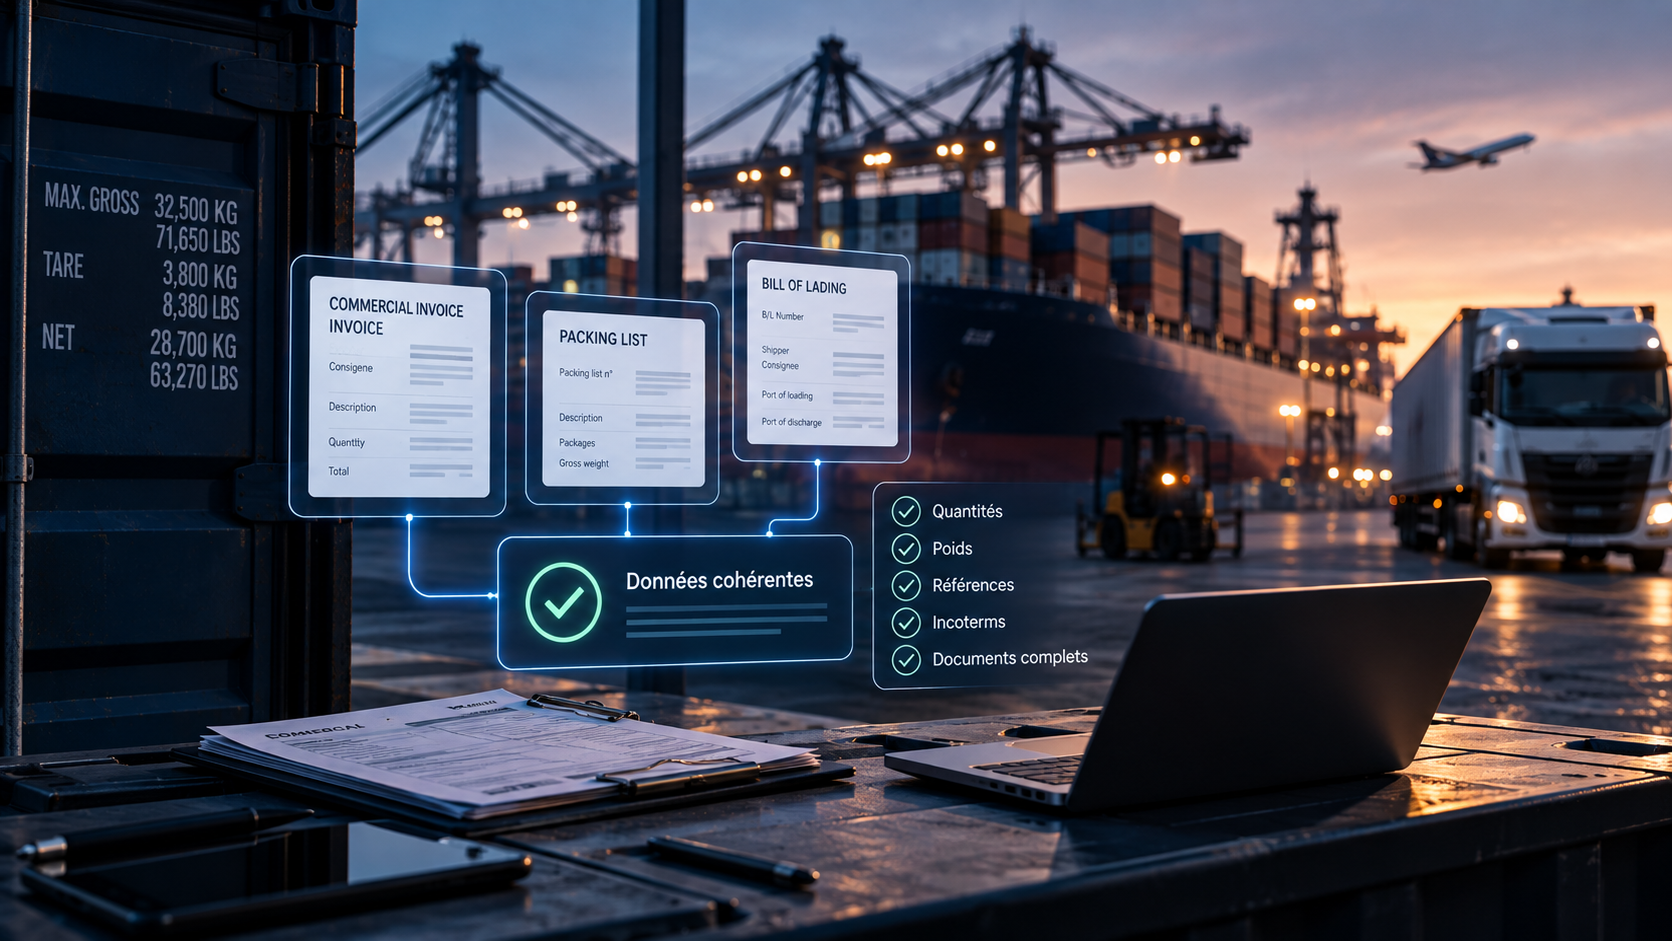
Une référence mal saisie, une quantité inversée ou un poids incorrect semblent être de simples erreurs administratives. Dans une opération logistique, elles se propagent dans plusieurs systèmes et provoquent des retards, des erreurs de facturation ou des difficultés lors du dédouanement.
Le problème est particulièrement important lorsque les données circulent entre emails, PDF, documents de transport, TMS, ERP, WMS et outils douaniers. Une même information peut être saisie plusieurs fois, par plusieurs personnes, dans plusieurs systèmes.
La première réponse consiste à réduire la saisie manuelle grâce à l’automatisation.
Mais automatiser la saisie ne garantit pas à lui seul la fiabilité des données.
Une information peut être correctement extraite d’un document et rester incohérente avec les autres informations du dossier. Pour réellement sécuriser les opérations, il faut aller plus loin : réduire les ressaisies, contrôler les données et vérifier leur cohérence à l’échelle du dossier de transport.
Les opérations logistiques reposent sur une grande quantité d'informations qui doivent circuler rapidement entre plusieurs acteurs et plusieurs systèmes.
Une expédition internationale peut notamment mobiliser :
Ces documents arrivent par email, sous forme de PDF, via un portail partenaire ou directement depuis un système métier.
Les mêmes informations apparaissent à plusieurs endroits : références, quantités, poids, valeurs, devises, dates, adresses ou Incoterms.
Lorsque ces données sont ressaisies dans plusieurs outils, chaque nouvelle saisie constitue un risque supplémentaire d’erreur.
Les erreurs concernent :
Ces erreurs ne résultent pas nécessairement d’un manque d’attention. Elles sont souvent liées à la multiplication des documents, des outils et des interventions manuelles.
C’est l’un des points les plus importants lorsqu’on cherche à fiabiliser les opérations logistiques.
Toutes les erreurs de données ne sont pas des erreurs humaines.
Un opérateur lit « 12 500 kg » sur un document et saisit « 12 050 kg » dans son système.
L’information présente dans le document était correcte, mais elle a été mal retranscrite.
Un système automatisé analyse un document mais interprète incorrectement une information.
La saisie manuelle disparaît, mais le risque d’erreur ne disparaît pas nécessairement avec elle.
C’est une situation différente.
Chaque donnée peut avoir été correctement saisie ou extraite, mais les informations présentes dans plusieurs documents ne concordent pas.
Prenons un exemple :
Les trois valeurs peuvent avoir été correctement extraites.
Pourtant, le dossier présente une anomalie.
La question n’est alors plus seulement :
Que contient ce document ?
Elle devient :
Les informations de l’ensemble du dossier sont-elles cohérentes ?
C’est précisément le rôle de la réconciliation documentaire : rapprocher les informations provenant de plusieurs sources afin d’identifier les écarts et les anomalies. Cette approche permet d’aller au-delà de l’extraction d’un document isolé.
Réduire les erreurs nécessite d’agir sur l’ensemble du parcours de l’information, et pas uniquement au moment de la saisie.
La première étape consiste à éviter de recopier manuellement une information déjà présente dans un email ou un document.
L’extraction automatique permet de :
L’objectif est simple : capturer une information une fois et la réutiliser autant que possible.
La standardisation facilite également la détection des erreurs.
Elle porte sur :
Plus les données sont structurées, plus il devient facile de contrôler automatiquement leur validité et leur cohérence.
Une donnée extraite automatiquement ne devrait pas nécessairement être considérée comme fiable par défaut.
Elle peut être contrôlée selon plusieurs critères :
L’objectif est de ne pas seulement extraire une donnée, mais de déterminer si elle peut réellement être utilisée dans le processus opérationnel.
C’est souvent à ce niveau que les anomalies les plus difficiles à détecter apparaissent.
Une facture commerciale peut être comparée à une packing list. Une facture transport peut être rapprochée d’une cotation. Les données d’une déclaration peuvent être comparées aux documents qui la justifient.
Le système peut alors rechercher automatiquement :
Le processus ne s’arrête donc plus à l’extraction :
Extraire → vérifier → rapprocher → détecter les écarts → alerter.
L’automatisation permet de supprimer une grande partie des tâches répétitives. Mais elle ne doit pas être confondue avec la fiabilité.
Imaginons qu’une facture soit automatiquement analysée, que ses données soient extraites puis transmises directement au TMS.
Le processus est rapide.
Mais si la quantité indiquée sur la facture diffère de celle de la packing list, ou si le poids ne correspond pas au Bill of Lading, le système vient simplement de transmettre plus rapidement une information qui n’a pas encore été vérifiée.
C’est pourquoi le véritable objectif n’est pas seulement :
automatiser la saisie
mais :
automatiser la saisie tout en contrôlant la fiabilité de l’information.
Cette distinction est particulièrement importante lorsque plusieurs systèmes sont interconnectés. Une donnée incorrecte peut être automatiquement propagée vers plusieurs outils et devenir plus difficile à identifier et à corriger.
Une opération logistique ne repose presque jamais sur un document unique.
Les documents arrivent progressivement. Un ordre de transport peut être reçu en premier, suivi d’une facture, d’une packing list, d’un document de transport puis de documents réglementaires complémentaires.
Certaines pièces peuvent également être corrigées ou remplacées.
Le système doit conserver le contexte de l’opération au fur et à mesure que de nouvelles informations apparaissent.
C’est pourquoi le dossier de transport constitue un niveau de raisonnement plus pertinent que le document isolé.
Le document n’est alors plus considéré comme une information indépendante.
Le dossier devient l’objet à comprendre, contrôler et fiabiliser.
Une fois les informations rassemblées dans le contexte du dossier, de nombreux contrôles peuvent être automatisés.
Le système peut comparer :
Les informations présentes dans un Bill of Lading, une CMR ou un AWB sont comparées avec les autres données disponibles dans le dossier.
Les contrôles peuvent notamment porter sur :
Les montants facturés sont rapprochés des conditions tarifaires ou des cotations disponibles afin d’identifier les écarts.
Ces contrôles permettent de détecter les anomalies avant qu’elles ne deviennent des erreurs opérationnelles. Docloop utilise notamment le rapprochement de données provenant de plusieurs sources pour identifier les incohérences et effectuer des contrôles de cohérence et de conformité.
Réduire les erreurs de saisie ne signifie pas nécessairement supprimer l’intervention humaine.
L’automatisation prends en charge les tâches répétitives :
L’opérateur intervient lorsqu’une information est incertaine ou lorsqu’une décision métier est nécessaire.
L’objectif est de concentrer l’expertise humaine sur les exceptions, plutôt que sur la retranscription systématique des mêmes informations.
La question des erreurs de saisie conduit finalement à un problème plus large.
Il ne suffit pas de faire disparaître la saisie manuelle. Il faut s’assurer que l’information qui entre dans le processus logistique est fiable, cohérente, complète et exploitable.
Cela implique de passer progressivement de :
saisir → vérifier
à une logique plus complète :
capturer → comprendre → vérifier → rapprocher → détecter → recommander.
Cette évolution change également la manière de concevoir l’automatisation documentaire.
Le document n’est plus nécessairement l’unité centrale du traitement. Le système doit pouvoir comprendre les relations entre plusieurs documents, conserver le contexte de l’opération et identifier les anomalies qui apparaissent au niveau du dossier.
C’est dans cette direction que se développe une nouvelle génération d’IA documentaire : une IA capable non seulement de lire et d’extraire les informations, mais aussi de raisonner sur le dossier, de contrôler sa cohérence et recommander les actions nécessaires, à la validation de l'opérateur