FOIRE AUX questions
No items found.

L'IA assiste la classification des codes HS de deux façons : en suggérant un code à partir de la description d'une marchandise, et en contrôlant le code retenu au regard des documents du dossier. Le premier usage fait gagner du temps sur la recherche. Le second, plus rarement mis en avant, évite les erreurs : il vérifie que le code est cohérent avec la facture, la fiche technique et les autres pièces, signale les incohérences et explique son raisonnement. Dans les deux cas, la décision et la responsabilité restent au déclarant.
Le classement tarifaire est l'une des décisions les plus lourdes de conséquences d'une déclaration en douane. Le code détermine les droits, la TVA à l'import, les mesures de politique commerciale et les documents exigés. Or c'est aussi l'une des plus difficiles : le tarif douanier commun compte environ 15 500 lignes, selon la douane française. Voyons ce que l'IA y apporte réellement, et ce qu'elle ne peut pas faire.
Le code d'une marchandise se lit en trois niveaux (source : douane.gouv.fr) :
En France, des codes additionnels nationaux complètent le TARIC pour certaines taxes. Un outil qui « trouve le bon code SH » n'a donc fait qu'une partie du travail : ce sont souvent les 8e, 9e et 10e chiffres qui changent les droits ou déclenchent une mesure.
Le classement repose sur des textes juridiquement contraignants : les règles générales interprétatives (RGI), le libellé des positions et sous-positions, les notes de sections et de chapitres, ainsi que les règlements de classement de la Commission européenne. Les notes explicatives de l'OMD et de la NC guident l'interprétation. Classer, c'est raisonner sur la matière, la fonction, l'état de la marchandise, sa composition, parfois son conditionnement : un libellé commercial ne suffit presque jamais.
Le SH est révisé environ tous les cinq ans ; la prochaine édition, SH2028, doit entrer en vigueur le 1er janvier 2028. La NC est mise à jour chaque année. Un code « habituel », utilisé depuis des années pour un client, peut devenir faux du jour au lendemain.
Le déclarant est responsable de l'exactitude des informations déclarées (article 15 du Code des douanes de l'Union). Un classement erroné peut entraîner un redressement des droits et taxes, des pénalités, ou le non-respect d'une mesure (licence, interdiction, antidumping). Pour sécuriser un classement, l'opérateur peut demander un renseignement tarifaire contraignant (RTC), gratuit, qui lie les douanes de toute l'UE pendant trois ans au maximum.
C'est l'usage le plus connu. À partir d'une description (désignation, matière, fonction, usage), un modèle propose un ou plusieurs codes probables, souvent avec un niveau de confiance et des alternatives. Les modèles de langage récents savent raisonner sur la description plutôt que sur des mots-clés.
Les performances sont réelles mais doivent être lues avec précision. Une étude menée avec le service des douanes coréen (arXiv 2111.01663) atteint 95,5 % de bonnes réponses parmi les trois premières suggestions, au niveau des sous-positions à 6 chiffres, sur près de 130 000 déclarations passées. C'est un bon résultat d'aide à la recherche, pas une garantie de code déclaré à 10 chiffres.
C'est l'usage le plus utile pour un transitaire ou un déclarant, et le moins décrit. Le code a déjà été proposé (par un collaborateur, un client, un fichier article, l'historique ou une IA) ; il s'agit de vérifier qu'il est cohérent avec tout ce que disent les documents :
Ce contrôle s'appuie sur la réconciliation documentaire : rapprocher les données des différentes pièces pour voir si elles racontent la même histoire. Une IA qui lit le dossier complet voit des erreurs qu'aucun outil de suggestion, nourri d'une seule description, ne peut voir. C'est le principe développé dans notre article Pourquoi un agent IA logistique doit-il raisonner sur un dossier complet ?.
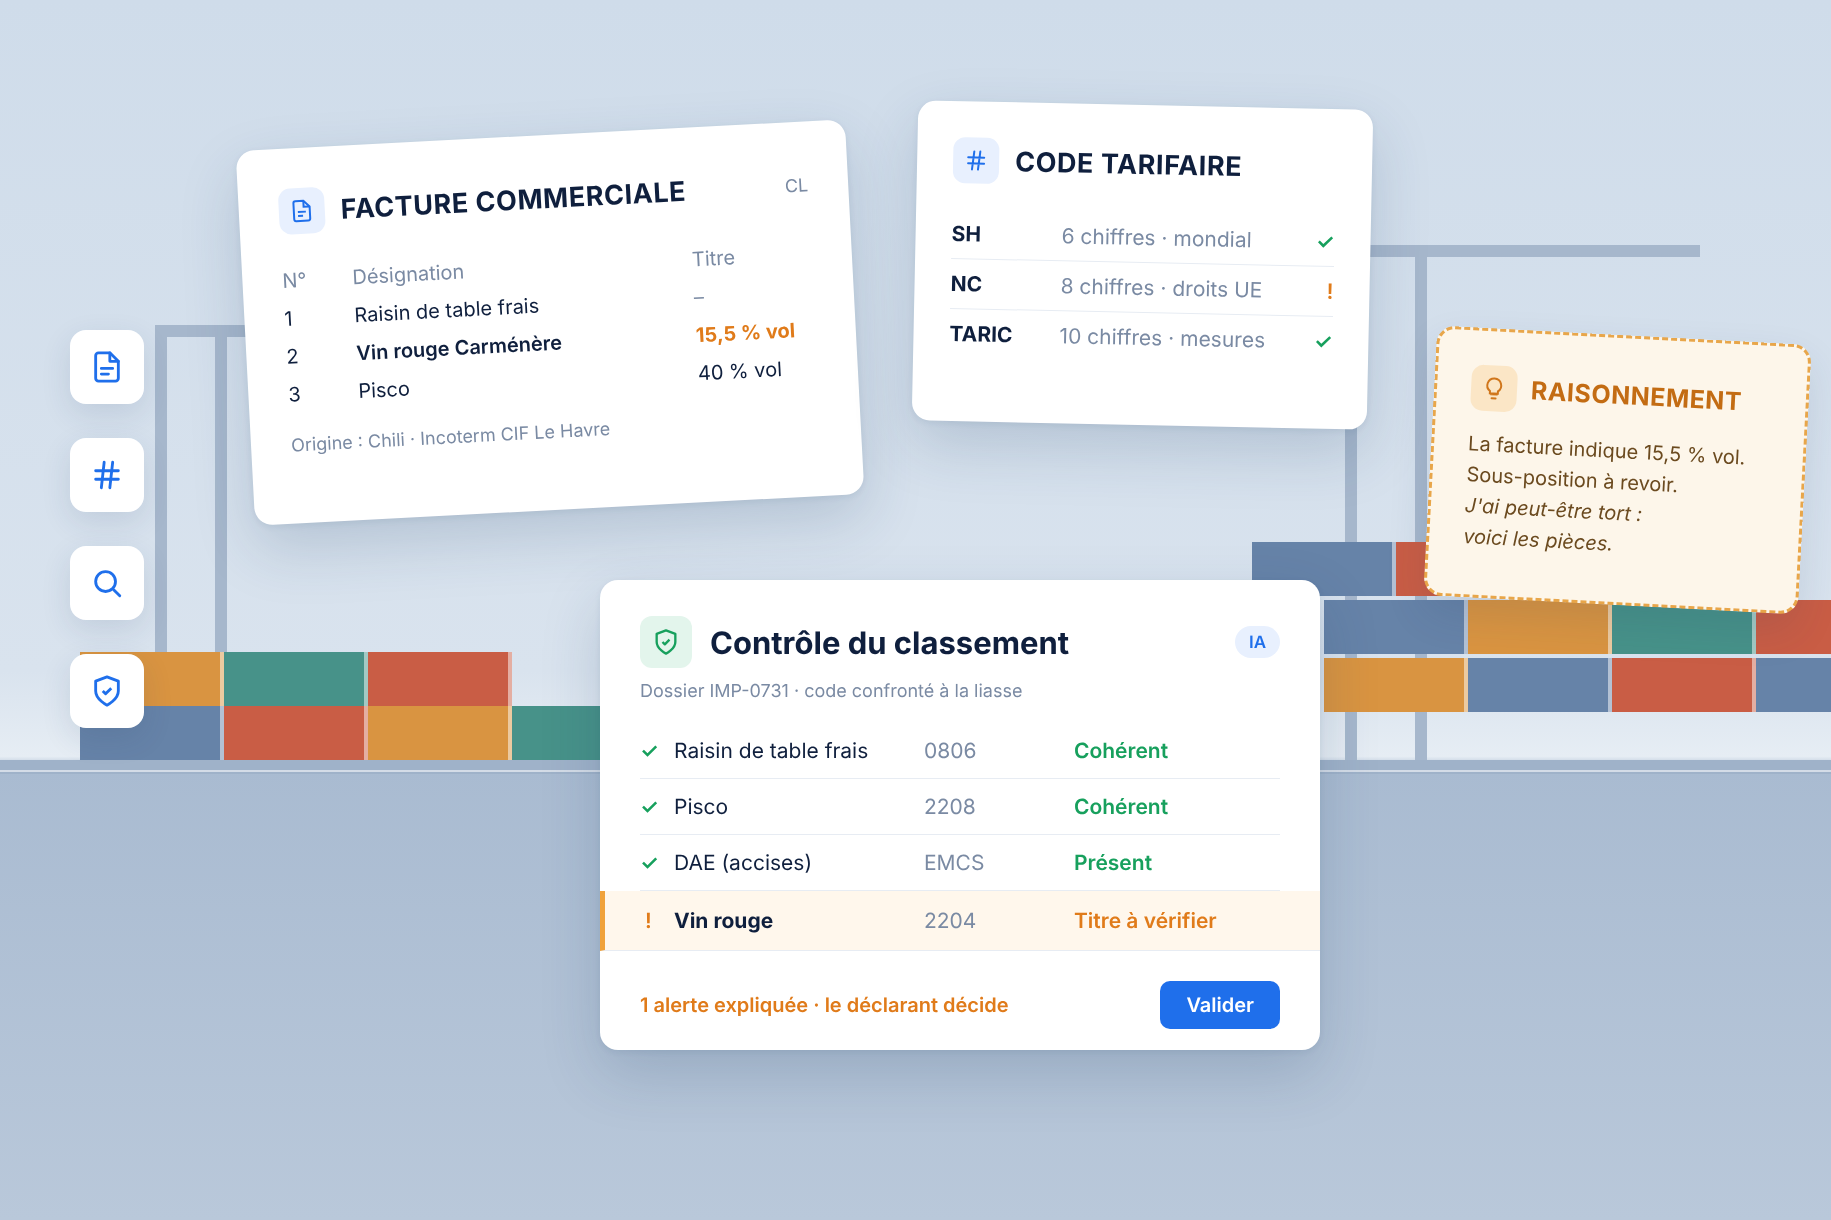
Ce cas a été présenté par Docloop lors d'une démonstration rapportée par Profession Logistique (n°11, automne 2026). Un importateur reçoit du Chili un envoi mêlant raisin frais, vin et pisco.
Sur le papier, le classement semble simple : le raisin frais relève du chapitre 8 (position 0806), le vin du chapitre 22 (position 2204), le pisco, eau-de-vie de raisin, de la position 2208. Mais au sein de la position du vin, la nomenclature combinée distingue les vins selon leur titre alcoométrique acquis. Le code retenu ne tenait pas compte du titre indiqué dans les documents, une erreur typique, selon Aymeric Le Page, CEO et co-fondateur de Docloop.
Le système l'a repéré en confrontant le code à la donnée extraite des documents. Il a proposé un autre code en exposant tout son raisonnement, sur un ton volontairement humble : en substance, « je pense qu'il s'agit plutôt de ce code, puisque le vin dépasse tel titre ; j'ai peut-être tort, mais voici mon raisonnement pour que vous décidiez ». Dans le même dossier, il signalait aussi un certificat lié au pisco manquant et un DAE requis puisque l'envoi contient de l'alcool : le code et les documents se contrôlent mutuellement.
Ce que montre ce cas : l'erreur ne se voyait ni dans le code seul, ni dans la facture seule, mais dans leur confrontation.
Facture, packing list, fiche technique, certificats : plus le système dispose d'informations sur la marchandise, plus sa suggestion et son contrôle sont fiables. L'extraction doit récupérer les caractéristiques utiles au classement (matière, composition, titre, fonction), y compris dans des documents rédigés en espagnol, en anglais ou en chinois. La différence entre OCR et IA documentaire sur ce point est détaillée dans OCR ou IA documentaire : quelles différences pour la logistique ?.
Fichier articles, codes habituels par client, RTC détenus, décisions passées : ce sont des règles métier internes, qui complètent les règles réglementaires (RGI, notes, TARIC). Un code qui diffère de celui retenu les dix dernières fois pour le même article mérite une alerte, tout comme un code qui ne correspond plus à la nomenclature en vigueur.
Confronter le code aux caractéristiques extraites, aux mesures TARIC et aux autres documents du dossier. Les incohérences entre facture, packing list et document de transport, qui faussent souvent la désignation, sont détaillées dans notre article sur la détection des incohérences entre facture, packing list et Bill of Lading.
Chaque alerte doit dire pourquoi le code paraît douteux et sur quelle pièce elle s'appuie. C'est ce qui permet au déclarant d'écarter une fausse alerte en quelques secondes, et de se prémunir contre les hallucinations toujours possibles d'une IA. Les alertes doivent arriver là où l'équipe travaille déjà : messagerie, TMS ou logiciel de dédouanement.
Repasser sur les déclarations déposées permet de repérer les erreurs récurrentes, de corriger les fichiers articles et de préparer les mises à jour de nomenclature (SH 2028 notamment). Pour un Opérateur Économique Agréé, cette revue nourrit l'autocontrôle. Selon Docloop, elle devient aussi un outil de formation : repérer les erreurs types d'un collaborateur junior, c'est lui apprendre à ne plus les commettre.
Ce principe de supervision humaine graduée est détaillé dans notre article Document-centric agentic AI : définition.
Avant de choisir un outil, posez ces questions :
Le meilleur test reste un essai sur vos propres déclarations passées : comparer les alertes de l'outil aux corrections réellement apportées.
Le contrôle du code fait partie d'une démarche plus large, décrite dans notre article Comment automatiser le contrôle documentaire douanier ?, et c'est l'un des contrôles réalisés par le Customs Compliance Engine de Docloop.
Docloop dans Profession Logistique. Dans son numéro 11 (automne 2026), le magazine consacre quatre pages à la réconciliation documentaire de Docloop, dont la détection d'un code tarifaire incohérent avec le titre alcoométrique d'un vin. Le module de réconciliation y est présenté comme en test chez plusieurs transitaires et déclarants en douane. Docloop a par ailleurs été lauréate Tech for Change 2025 à VivaTech et de l'appel à projets France 2030 opéré par l'ADEME.