FOIRE AUX questions
No items found.

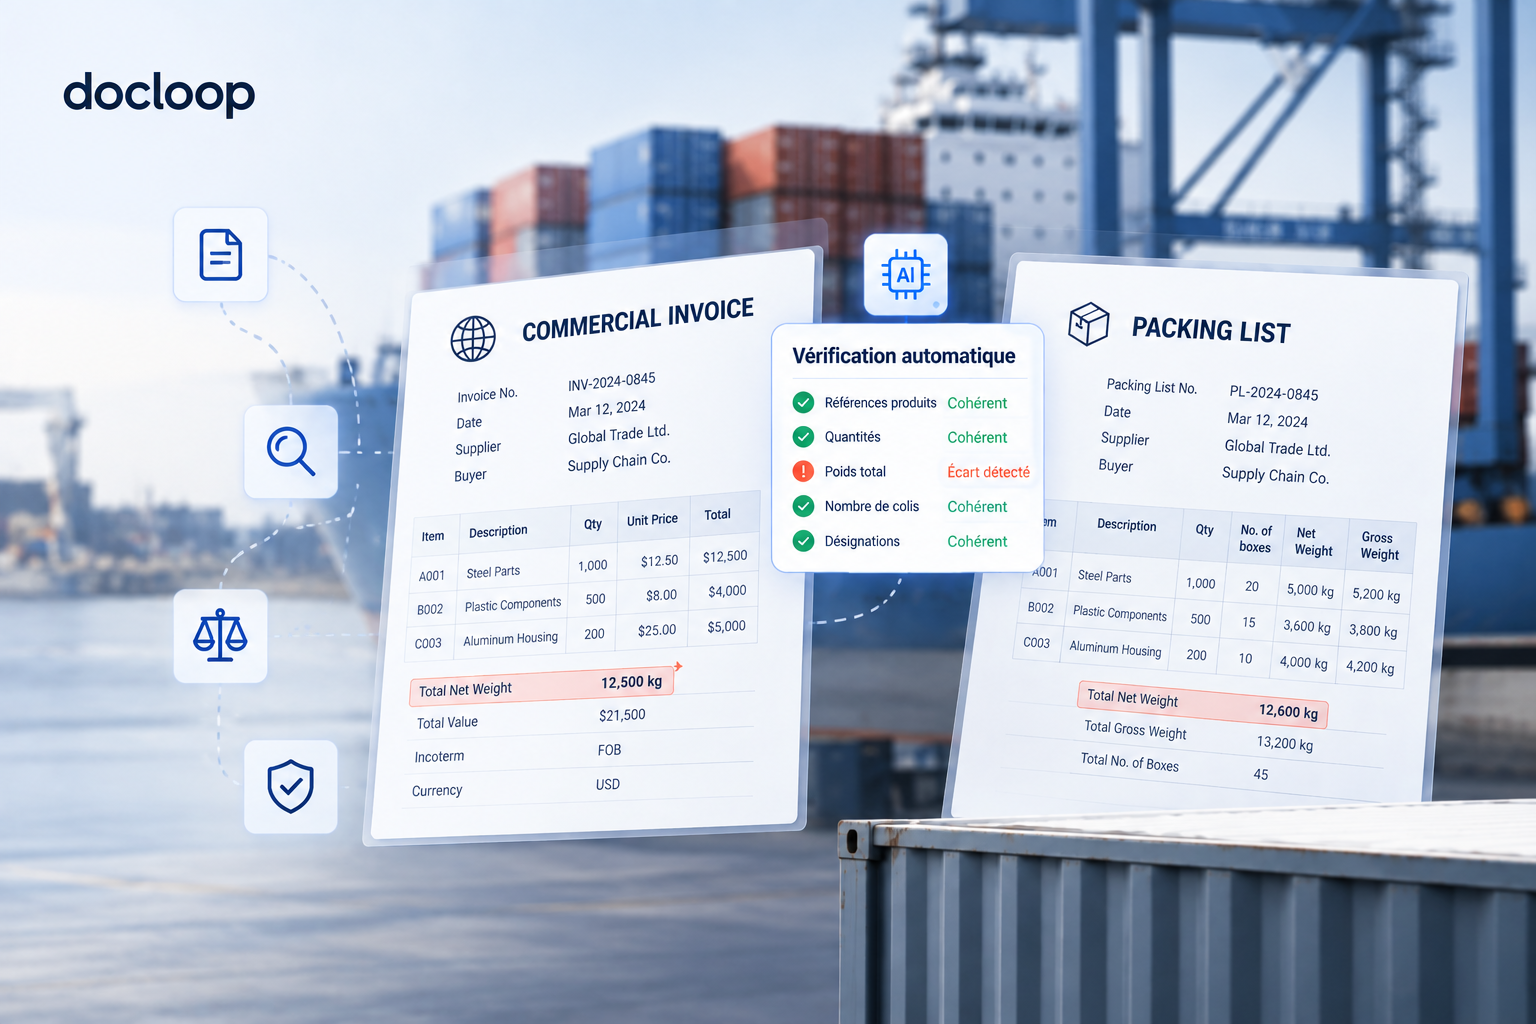
Une facture commerciale indique 12 500 kg.
La packing list indique 12 600 kg.
Et le Bill of Lading mentionne 12 850 kg.
Les trois documents sont pourtant parfaitement lisibles. Les données ont été correctement extraites. Aucun problème d’OCR, aucune erreur apparente de lecture.
Alors, où est le problème ?
Les documents ne racontent pas exactement la même histoire.
C’est une situation fréquente dans les opérations de transport et de commerce international. Une même expédition est décrite par plusieurs documents : facture commerciale, packing list, Bill of Lading, commande, documents douaniers, certificat d’origine ou encore facture de transport. Chacun contient une partie des informations nécessaires à l’opération.
Le véritable enjeu n’est pas seulement de réussir à lire ces documents. Il est de pouvoir répondre automatiquement à une question beaucoup plus importante :
Les informations présentes dans ces documents sont-elles cohérentes avec la même opération ?
C’est là que commence la réconciliation documentaire.
Avant de parler d’automatisation, il faut distinguer le rôle de ces deux documents.
Ces documents ont des informations en commun, mais ils ne sont pas censés être identiques.
Une facture et une packing list doivent être cohérentes sur les informations qu’elles ont en commun, pas nécessairement présenter les mêmes données.
Le premier principe de la vérification automatique est de savoir quelles données doivent réellement correspondre.
À première vue, le problème semble simple. Il suffirait de prendre les informations de la facture, celles de la packing list, puis de vérifier si les valeurs sont identiques.Mais cette approche atteint rapidement ses limites.
Une différence n’est pas forcément une erreur
Imaginons :
Facture : 1 000 unités
Packing list : 960 unités
Un système de comparaison détecte immédiatement un écart.
Mais si la commande correspond à 960 unités, la situation est parfaitement explicable.
Il peut s’agir :
Le système doit éviter de transformer automatiquement chaque différence en erreur.
Il doit chercher à comprendre l’écart.
La comparaison pose une question simple :
Les deux valeurs sont-elles identiques ?
La réconciliation pose une question métier :
Ces deux informations décrivent-elles la même réalité et, si elles diffèrent, pourquoi ?
Cette distinction est fondamentale.
La réconciliation documentaire consiste à rapprocher les informations présentes dans plusieurs documents afin de détecter les incohérences avant qu’elles ne deviennent des problèmes opérationnels.
Comparer permet de trouver une différence. Réconcilier de comprendre cette différence.
Une vérification fiable repose sur plusieurs étapes. L’objectif n’est pas simplement de comparer deux PDF, mais de transformer les informations documentaires en données contrôlables.
Le système commence par reconnaître les documents présents dans le dossier :
Cette étape permet de ne pas traiter chaque fichier comme un document isolé. Une expédition internationale regroupe de nombreuses pièces, reçues à différents moments et provenant de différentes sources.
L’IA documentaire extrait :
C’est le rôle traditionnel de l’OCR et surtout de l’Intelligent Document Processing.
Mais l’extraction n’est que le point de départ.
Une information extraite automatiquement n’est pas nécessairement une information fiable dans son contexte.
Une facture peut parfaitement indiquer « 12 500 kg » et une packing list « 12 600 kg » sans qu’il y ait eu d’erreur de lecture.
Le problème n’est donc plus de savoir ce qui est écrit, mais de déterminer si cette information est cohérente avec les autres informations du dossier.
Avant de comparer les données, il faut pouvoir gérer :
Cette étape évite de créer des anomalies artificielles. Par exemple, comparer directement une quantité exprimée en tonnes avec une autre exprimée en kilogrammes pourrait générer un faux écart. L’automatisation doit d’abord s’assurer que l’on compare des informations comparables.
Une même marchandise peut être présentée différemment dans une facture et une packing list. Le système doit identifier les éléments qui correspondent réellement.
C’est particulièrement important lorsque les documents contiennent plusieurs références ou plusieurs niveaux de conditionnement.
Une facture peut présenter :
Produit A — 500 unités
alors que la packing list présente :
Produit A — cartons 1 à 10 — 500 unités.
La structure est différente, mais l’information désigne la même marchandise.
Une fois les données identifiées, normalisées et rapprochées, le système peut effectuer les contrôles.
Par exemple :
Quantités
Facture : 1 000
Packing list : 1 000
→ Cohérent
Références
Facture : SKU-4587
Packing list : SKU-4587
→ Cohérent
Poids
Facture : 12 500 kg
Packing list : 12 600 kg
→ Écart détecté
Colis
Facture : 50 cartons
Packing list : 52 cartons
→ Écart à analyser
Mais l’automatisation ne doit pas s’arrêter à cette étape.
Un écart peut être :
La qualité de l’automatisation dépend donc autant de la qualification des anomalies que de leur détection.
Une fois l’écart identifié, le système peut :
L’objectif n’est pas de remplacer l’expert, mais de lui éviter de rechercher manuellement les anomalies dans l’ensemble du dossier.
La vérification entre facture et packing list peut couvrir plusieurs catégories d’anomalies.
Facture : 1 000 unités
Packing list : 960 unités
→ Écart à analyser.
Le système recherche la quantité indiquée dans la commande ou dans d’autres documents du dossier.
Facture : SKU-4587
Packing list : SKU-4589
→ La référence ne correspond pas.
Cela signale une erreur de saisie, une mauvaise référence ou une modification non répercutée.
Les deux documents utilisent des formulations différentes pour une même marchandise. Le contrôle doit alors pouvoir distinguer une différence de formulation d’une véritable différence de produit.
Facture : 12 500 kg
Packing list : 12 600 kg
→ Écart détecté.
Mais il faut également vérifier la nature de la donnée :
Un contrôle pertinent doit donc connaître le type de poids comparé.
Facture : 50 cartons
Packing list : 52 cartons
→ Écart à contrôler.
Là encore, le contexte peut expliquer la différence.
La cohérence ne concerne pas uniquement les données contradictoires.
Un document peut être incomplet :
La vérification documentaire doit donc combiner cohérence et complétude.
C’est probablement le point le plus important pour comprendre la différence entre un contrôle documentaire basique et une approche plus avancée.
Prenons le poids.
La facture peut mentionner :
Poids net : 12 500 kg
La packing list :
Poids net : 12 500 kg
Poids brut : 12 600 kg
Il n’y a pas d’incohérence.
Les deux documents ne présentent simplement pas exactement la même information.
Même logique pour les quantités.
Facture : 1 000 unités
Packing list : 960 unités
Commande : 960 unités
Le système doit pouvoir comprendre que l’écart entre facture et packing list mérite une vérification, mais que la commande apporte un élément de contexte essentiel.
C’est pourquoi l’objectif n’est pas de faire « matcher » deux documents.
L’objectif est de vérifier que les informations décrivant une même opération sont cohérentes entre elles.
Il est utile de distinguer plusieurs niveaux.
Mais la réconciliation permet de confronter les informations. C’est une distinction importante dans l’automatisation documentaire.
Une solution peut parfaitement extraire les données d’une facture et d’une packing list sans pour autant savoir si ces données sont cohérentes entre elles.
Une donnée peut être parfaitement extraite et pourtant être incohérente avec le reste du dossier.
Une facture et une packing list ne vivent presque jamais seules. Une opération internationale mobilise aussi :
Chaque document contient une partie de l’information. Le problème apparaît lorsque ces différentes sources ne concordent plus. C’est pourquoi le contrôle ne doit plus seulement porter sur :
Facture ↔ Packing list
mais progressivement sur :
Facture ↔ Packing list ↔ B/L ↔ commande ↔ données opérationnelles
On passe ainsi du document au dossier.
Un dossier de transport évolue.
De nouveaux documents arrivent. Une facture est corrigée. Une packing list est remplacée. Une validation est effectuée. Un événement opérationnel peut modifier l’interprétation d’une donnée.
Traiter chaque document séparément fait perdre une partie de ce contexte.
Le dossiers doit conserver :
La vérification n’est alors plus une action ponctuelle. Elle devient un contrôle documentaire continu.
Une bonne automatisation ne doit pas simplement afficher :Mismatch
Elle doit rendre l’anomalie compréhensible et exploitable.
Par exemple :
Facture
1 000 unités
Packing list
960 unités
Commande
960 unités
Analyse
Écart entre la facture et la packing list. La commande correspond à la packing list.
Action recommandée
Vérifier si la facture doit être corrigée.
L’opérateur dispose ainsi immédiatement des éléments nécessaires pour prendre une décision.
Cette logique est importante dans les processus documentaires complexes : l’IA automatise les contrôles et concentre l’intervention humaine sur les exceptions, plutôt que de chercher à remplacer systématiquement l’expertise métier.
La traçabilité est également essentielle : document source, donnée concernée, anomalie détectée, contrôle appliqué et décision prise doivent pouvoir être retrouvés.
Le dossier ne reste pas figé. Un nouveau document arrive après la facture et la packing list. Une nouvelle version peut remplacer une ancienne. Une information est corrigée. Une validation peut modifier le statut d’un contrôle.
C’est pourquoi la réconciliation documentaire ne devrait pas être pensée comme une vérification ponctuelle réalisée une seule fois. Elle peut devenir un contrôle continu du dossier.
C’est finalement ici que se situe la différence entre une simple automatisation de documents et une approche réellement métier.
Facture : 1 000
Packing list : 960
→ Différence.
Facture : 1 000
Packing list : 960
Commande : 960
→ Écart identifié et contextualisé.
Écart analysé → source de référence identifiée → action recommandée → décision tracée.
Cette progression est au cœur de l’approche Docloop. La fiabilisation documentaire ne consiste pas seulement à extraire davantage de données. Elle consiste à transformer des documents dispersés en informations vérifiées, cohérentes et directement exploitables dans les processus métiers.
Automatiser le contrôle entre une facture commerciale et une packing list semble simple. Mais un contrôle réellement fiable doit aller beaucoup plus loin :
identifier les documents → extraire les données → normaliser → faire correspondre → contrôler → détecter les écarts → les contextualiser → recommander une action.
La différence est importante. La comparaison cherche une différence.
La réconciliation cherche à comprendre cette différence.
Et la fiabilisation documentaire va encore plus loin : elle permet de s’assurer que les informations utilisées pour piloter une opération logistique sont cohérentes, complètes et exploitables.
C’est pourquoi la véritable automatisation documentaire ne consiste plus seulement à faire passer une information d’un PDF vers un TMS ou un ERP.
Elle consiste à vérifier que cette information est fiable avant de la faire circuler dans le processus.